plasmasphere.net -プラズマスフィア ドットネット-
Diary
ローカル LLM エージェントと一緒 第三章、音声認識
2026/10/11(Sun) 16:10
テキスト入力は簡単だ、キーボードを叩くだけだからだ。
しかし音声入力は違う、入力した音を「日本語」としてテキストに起こさないといけない。
残念ながらここは本当に全く知識が無い(whisper がスタンダードらしい、くらいしか知らない)、Claude 先生に事前調査をしてもらい、内容と詳細な実装提案を出してもらう。
どうやら日本語の認識は鬼門らしい…。
提案は以下の内容だった。
- スタンダードに whisper を使う。日本語認識は実績はあるが精度はイマイチ、ただし確実に使える。
- sharpa-onnx と ReazonSpeechを試す。日本語認識の情報は少ないので手戻りになる可能性ある。
Claude 先生は 1. を推奨したけど、手戻ってもいいからやってみてと 2. をお願いした。
ダメならやり直せばいい、仕事じゃなく趣味だし。
これが正解だった、多少曖昧な発音でも認識してくれるし、解析間違いがほぼ無い。
https://research.reazon.jp/projects/ReazonSpeech/index.html
ReazonSpeechは、世界最大のオープン日本語音声コーパスを構築するプロジェクトです。 ・日本語音声技術の推進を目的として、35,000時間の日本語音声コーパスを公開しています。 ・音声認識モデル・コーパス作成ライブラリをオープンソースライセンスで配布しています。
神でしかない。 神、所謂ゴッド。
ここまできたらあとは音声会話の起点だけ。
例えば Amazon なら「アレクサ」で反応してくれるけど、これをやりたかった。
常にマイクをオンにして、常にすべての音を拾うと LLM に投げる内容もとっちらかるし、何なら音楽聞くのも無理になってしまう。
最初は先生の提案で、sherpa-onnx のキーワード検出(KWS)を試した。
専用の仕組みなので本命のはずだったが、試してみたらうまくいかない。
どうしても発話の最初が切れる。「アレクサ」が「クサ」とか「レクサ」とか。「あーあー、アレクサー」だと「あーアレクサ」辺りで認識する。
どうも音声認識した最初の辺りはちゃんと拾えないんだな、要するにマイク自体のウェイクワードってやつかハハハこやつめ。
ウェイクワードにフィラーを入れるのはどうよ…ん-、とってもヤ☆(2歳の娘のイヤイヤ期の真似)
所謂暗礁乗上。Claude 先生も色々提案してくれるけど、どれもピンとこない。
そこで発想を変えてみた。(ちなみに1日寝かせてる。頭の切り替えは寝るのが一番いい。あと寒い夜。)
普段は「待ち受け」状態で、喋り声を検知したら一旦文字に起こしたらいいのでは?と。
ReazonSpeech はほぼほぼ正確だったわけだし。
その中にウェイクワードが入っていたら「聞き取り」状態に切り替える。
ウェイクワード専用の仕組みは使わず、普通の音声認識を流用するという形。
これはうまくいった。
Silero VAD という発話検出を使って人の喋っている部分とそれ以外を切り分けてから ReazonSpeech に通す。
音声全部通していると負荷がえらいことになるので、ここは Claude 先生が提案してくれた。
CPU負荷は断然 Silero VAD を通した方が軽くなった。
しかも Silero VAD は喋り始めたところの少し前から切り出してくれるので、喋り始めが切れなくなった。
音声認識自体は良くなったが、しかし中々難しい。ウェイクワードは短すぎると関係無い単語拾うし、長いとめんどくさい。
それに音声認識は「あれくさ」と「アレクサ」のように表記が揺れるけど、そこは曖昧一致で吸収した。
ウェイクワードは「なると」にした。勿論設定で変えられるようにもした。
このあたりから「なると」のお陰でモチベーションが上がってくる。
語尾の「ぷるるーん!」と、自認が「ラーメンに浮くことが至上」のキャラ設定のお陰で会話が意味不明で楽しい。
そして声が可愛いのでおバカ可愛くなる。
自分よりも家族がハマってた。なるとが喋ると娘が大笑いする。
この子は化ける、間違い無い。
ウェイクワードが認識できるという事は波形が取れるということ。なら話している人の認識もできるかもしれない。
poiq を思い出しながら(まだ電源は入るけど、当然喋ってはくれない)Claude 先生に聞いてみる。
ちゃんと調べてくれた、どうやらできそう。
短い会話だとサンプリングが足らないので、文面も含めて Claude 先生に依頼した。
技術的に何をやってるのか全然分かってないけど、できたものは自分を認識してくれたからOK(スゲー)
因みに、キーボードのキーを押している時だけマイクを有効にする、という事も考えたけど、これは止めた。
この機能自体は Fedora サーバで動かす予定だったのだけど、Fedora 43 は標準が Wayland になっていて、Wayland はグローバルホットキー(キーボードの監視)ができないらしい。
セキュリティの都合なんだろうけど、そうなると選択肢は限られるわけで…。
Claude 先生が言うには、「他のアプリ宛てのキー入力を横取りできない」ということ。
/dev/input を直接読む方法(ユーザーを input グループに入れる)なら監視自体はできますが、権限が強すぎるので選ばなかった
ウェイクワードの反応は最初 beep 音だったけど、味気ないので登録済のサウンドを流すように変えてもらった。
AivisSpeech で「なに?」「よんだ?」「うん?」を出力した。
「なると」と声をかけると、すぐに「なに?」と返事がある。素晴らしい。
その後の返事に時間かかるのだけども(LLM経由するから)
余談だが、人が喋っているところとそれ以外を切り出す、のが VAD だけど、これは「喋る」のを切り出すので、テレビの音声も当然拾う。
テスト中にそこまで言って委員会を流してたら、誰かの音声を拾ってLLMに流してて凄い会話になった事もあった。
そんな難しいことを考えるモデルじゃねーのよ Bonsai 8B は。
ローカル LLM エージェントと一緒 第二章、設計とお布施
2026/10/10(Sat) 16:10
Claude 先生には voicevox-openai-tts と同じ処理を Rust に組み込んでもらった。
ここはpythonでもうあるから必要ない、とチャットの先生は言ってたけど、あれこれ起動させると覚えられない(主に起動コマンドを)ので組み込む方向に舵を切った。
どうも Claude 先生は「自分が提案した」と言って引かないけど、Rust で書くなら纏めりゃいいじゃん…とこちらも思ってたのでね。
具体的にやって欲しいことを Claude 先生に投げる。
因みに、ローカルの開発環境なので Claude Code をハーネスにしてる。チャットではない。
このパスのこの python コードを Rust で書き直して RAG プロジェクトに組み込んで下さい
いくつか実装までの確認はあった。
こんな内容だった。
- 全く同じようにサーバを立ててサーバで受け取る。要するにRAG→RAG内のブリッジサーバ→ブリッジからAivisSpeechに投げる
- RAG から直接 AivisSpeech を叩く
こんなもん2に決まってる。
Claude 先生の提案も2推奨だった。そりゃそうよ。
ここでついでにシステムプロンプトにキャラクタ設定もできるように機能を追加した。
RAGで作ってたUIのアイコンがラーメンに浮いてる🍥だったので、とりあえず自認がラーメンに浮くのが至上の喜びの「なると」を作った。
イメージに半熟英雄の「なると」があったのは間違い無い。ぷるるーん。
これが後から大変なモチベーション維持に役立ってくれることになるとは思ってもいなかったのは嬉しい誤算だった。
機能が増えたので出力口を統合してクローンコードを可能な限り書かない方針を Claude 先生に伝えた。
将来的に Open-LLM-VTuber 的に使おうとした場合、デスクトップペット側だけを切り離してコア部分はサーバとして動かしたかったからだ。
この方針は Claude 先生も納得してくれた。
ソフトとして、コーディングとして、大事な部分が決まった。
実装的には、文単位のセグメント分割とか、TTS に渡す処理系とか結構色々あるけど、細けえことは良いんだよ!の精神で進む。
先生がええようにやってくれてるから。
因みに、途中からソースコードのレビューはやってない。表に出すもんでもないし。
でも寝る前に読んだりはした、良い入眠剤になった。
ローカル LLM エージェントと一緒 第一章、設計とお布施
2026/10/04(Sun) 16:10
第一章 設計方針
コーディングできなくても先にできることはある。そう、設計である。
必要な機能の分解はフリー状態の Claude 先生と壁打ちして詰めていきつつ、コーディングエージェントの調査を進める。
ちなみに先生は無課金だとあっちゅう間に上限にいく、しかも残りのトークンが分からない。
README.mdを出力してもらうとマジですぐそっぽ向くので、壁打ちしながら自分で設計をまとめた。
設計と言っても機能概要と必要な技術だが。
最初に考えたのは python で作った AivisSpeech→OpenAI のラッパーサーバを RAG 側に組み込んでしまう事だった。
もともと python のコードもあるし、このくらいなら先生じゃなくても大丈夫だろうと。
ちなみに、コーディングエージェント調査の方は Claude 先生はあんまり役に立たない。
RTX3060 ではまともにエージェントが動かない?分かってんだよでも持ってんのは RTX3060 なんだよ。
色々試して先生にお布施するか…と諦めかけた時に FreeToken がリリースされる。
早速使ってみるが Qwen3.6 35B A3B でちゃんとコーディングできてる、凄い。でもすんげえ重い。
2週間ほど頑張ってみたが流石に遅すぎる(それでも自分で Rust のコード書くより早いけど)ので、先生へのお布施を決意。
ちなみに Claude 先生に課金する時は GooglePlay アプリ経由だと手っ取り早い。Anthropic 直でクレカ決済しようとすると、日本国内からだとほぼ弾かれる。
Claude 先生に設計と既存コードを読んでもらった結果、大部分が書き直しになった。マジかよ…
しかし先生の言うことは大体正しい。
ちゃんとエージェント設定もしていて、ユニットテスト先行で実装してくれるし、仕様が不明瞭なところは必ず確認してくれるし、実装の提案もしてくれる。
たまに他の機能と整合性の取れてない仕様だしてくるけど、そこは他を流用できないから、という理由を言い続ける。
/compactするまでは覚えてくれていて、他機能と連携できない、他機能と似ているのに別の機能を作る、みたいなことはなくなった。
オートモードも相まってあまりに実装が早い。
しかし今思えば、せめて python の置き換えくらいは自分で作っても良かったかもしれない。
おかげで完全に自分で Rust のコード書けなくなっちゃってるし。
ローカル LLM エージェントと一緒 第零章、前史(Open-LLM-VTuber編)
2026/10/03(Sat) 14:10
これは、ローカルLLMでローカルエージェントを作って遊ぶ(運用)までの Claude 先生との記録である。
前史、自作を決意するまで
何かの動画で見つけた Open-LLM-VTuber が楽しそうだったので使ってみた。
設定項目がやたら多い、Live2dのキャラが動くだと…??ローカル LLM の OpenAI 互換 API を設定してデスクトップペットが作れるというのは分かったので、とりあえず Live2d キャラを自作してみる。
絵描ところからやるのが早いか、とりあえず生成してからやるのが早いか、悩んだ結果生成してもらうことにした。久々にローカルの Stable Diffusion WebUI を動かす。
100枚ほど生成して加工しやすそうな立ち絵を選ぶ。が、Live2d のパーツ分けが余りに大変。
この辺りは AI に任せるとヘナチョコになるのは目に見えてるので自分で画像加工したが、paint.net ではできることに限界がある。
5時間ほどかけて顔のパーツ分けが最低限完了、描きながらパーツ分けたほうが早かったのでは、判断ミスったな…等と思いつつ Live2d の設定へ。
なるほど、分からん。
ある程度設定したつもりで、Claude 先生に投げてみる。何と調整してくれた、先生は Live2d まで分かるのか…。
Live2D が Open-LLM-VTuber で動かない。そんな、Live2Dアプリ上ではちゃんと見えているのに…。
ブラウザのコンソールにはエラーが出続ける Model not ready for scaling yet
追いかけてみると以下の内容も。
  [CSM][I]Live2D Cubism Core version: 05.00.0000
  [CSM][E]csmHasMocConsistency: The Core unsupport later than moc3 ver:[5]. This moc3 ver is [6].
  [CSM][E]Inconsistent MOC3.
  [CSM][E]Failed to CubismMoc.create().
どうやら Live2D 側で Cubism Editor 5.3 で書き出すと、moc3 は ver 6 になるらしい。
Open-LLM-VTuber に同梱されている Cubism Core は 05.00。つまり moc3 ver 5 までしか読めないらしい…書き出しバージョンを 4.0 に下げたらエラーは無くなった。
エラーは、である。表示はされない。
ここも時間がかかったが、結局ブラウザで持ってるキャッシュのせいだった。WASM はキャッシュがしっかり効くらしい。効きすぎかもしれん。
ブラウザの開発者ツールを開いて、Network タブで「Disable cache」にチェックを入れてリロードして解決した。
ここからが更に大変だった。
まず音声、TTS は19種類も接続が準備されているが…OS標準搭載の Edge-TTS(ななみちゃん) は声があんまり可愛くないので別のTTS、ボイスモデルを探す。piper が良さそうということで設定するが、日本語対応モデルがない。
つくよみちゃんの piper-plus モデルを拾うも multilingual is not a valid PhonemeType で再生できない。
ガーンだな、早速詰まってしまった…で調べていると AivisSpeech を見つける。まおちゃんどちゃくそ可愛いやんけ…しかし Open-LLM-VTuber の TTS選択肢 に VOICEVOX 系の項目が無い
どうしたもんかと考えていると、Claude 先生が一つ案を出してくれた。Open-LLM-VTuber には openai_tts(OpenAI互換TTS)のプロバイダがあるから、これをラッパーすればいい、と。
ブリッジは /v1/audio/speech を受け付け、OpenAIの声の名前(alloy、coral など)を、voice_mappings/aivis-speech.json でAivisSpeechの話者IDに変換する
なるほど?わからん?
ここは Claude 先生に丸投げ。どうやら GitHub にライブラリを公開してくれている神がいらっしゃったようで、ほぼ利用できた。
ちなみに AivisSpeech は AivisSpeech-Engine\run.exe を叩くとGUI無しで起動できる。
Open-LLM-VTuber を動かすための中間ライブラリを挙げるとこれらになった。
・ローカルLLM(ここでは llama.cpp で Bonsai 8B を使う、サーバ起動)
・AivisSpeech(サーバ起動)
・AivisSpeech → OpenAI互換変換用ブリッジサーバ、サーバ起動
・Open-LLM-VTuber (サーバ起動)
と、全部API通信になるからサーバが立ちまくる。
何ならローカル LLM の間に RAG も入れてる。
動いたデスクトップペットは確かに凄かった。凄かったが、使わない機能も多いし引きずられて設定項目も多くて全く制御できない。
特に自発会話がイケてない。おそらく Electron で動いてるデスクトップペット経由で発火するから、フロントで何らかのエラーが起きると全部止まる。
これはちゃんとしてる頭の良い人が使うものであって、自分みたいに到着にとりあえず進める人には合わない。
なら自分で作れば良いんじゃない(ニチャア)
と思い立ったのが6月末のこと。
ちなみに「自分で」と書いてルビは「Claude 先生に」である。
幸いな事に、システムプロンプトを注入できるローカルLLM用のソフト(RAG)は前作ってたので、これをベースに開発を進めてみる。
しかし暗礁に乗り上げる。Claude 先生の課金が切れたのだ。
元々3ヶ月限定で買ったのだけど、いい所で切れた。
Rust のコードはテメーで書くもんじゃない、そう思っていた私はローカルコーディングエージェントを探す旅に出ることになった。
東京ゲームショウ2026
2026/09/22(Tue) 15:09
ちょうど関東で仕事をする都合があって、東京ゲームショウ2026に行ってきました。
6年ぶり4度目くらい、多分。
といっても、人が多すぎなのは良く分かっていたので試遊などは目的には無く。インディーゲームでさえ並ぶんだからいやもう無理よそりゃ。
目当ては物販でしたが、概ね欲しいものは買う事ができました。ただしスクエニとセガは無理、2時間待ちとか無理。
物販で良かったのはバンナムでしたね。物販専用サイトで注文した上でQRコードを発行してもらってからレジに行くという、在庫も分かるし店側も間違わないしで早くて楽。
エースコンバットのTシャツとカードケースを買いました。
逆に良くなかったのはTGS公式物販ですね。商品に番号振ってる割に購入シートさえ無く、レジで口頭で伝えるのみ。良くないですね。あと、行くたびに買ってたトートバック買えなかった、もっとちゃんと用意しておくべき。
見て回ったブースは自分が持ってる製品のところばかりです、ゲームほぼ関係ない。
岩国を舞台にしたゲーム(タイトル忘れた)、REALFORCE、Ben-Q、COUGAR、くらいだったかな。
あとは移動中にコンパニオンのおねーさんの写真撮らせてもらったりとか。COUGARのおねーさんが色々凄かった。
以前と比べて完全にゲームが市民権を得ているので人も多いし出店側も多いので、ビジネスデーは一日にして後は一般にするとか、ちょっと考えた方がいいんじゃないかなーと思いました。
コロナ過前に行ったときは16時半とか物販も試遊もガラガラだった覚えがありますが、今回は待機列はほぼ解消されてない。
入場人数とハコのサイズも合ってないので、会場変えるか日数増やすかしないと事故が起きそうです。
とはいえ、楽しくはありました。お祭りは楽しい。
FreeToken でコーディングエージェント構築
2026/09/06(Sun) 19:09
先日発表された推論エンジン、FreeToken でコーディングエージェントがお気楽に構築できたので備忘録です。
私のマシン構成は以下の通り。
OS: Win11 Home
RAM: DDR5 64GB
GPU: RTX3060 12GB
CPU: Core i7 14700F
FreeToken からインストーラをDLして実行します。インストールは適当に。
幸運なことに値上がりする前にメモリを買っていたので結構重いモデルも載せられます。
Qwen3.6-35B-A3B を試してみました。
FreeToken のGUIから簡単に導入できます。Downloadをクリックすると後はDLと構成含めてやってくれます。
モデルの導入後は左のメニューから Console を選んで、Cache config を Agent にするとコンテキスト多めにできます。
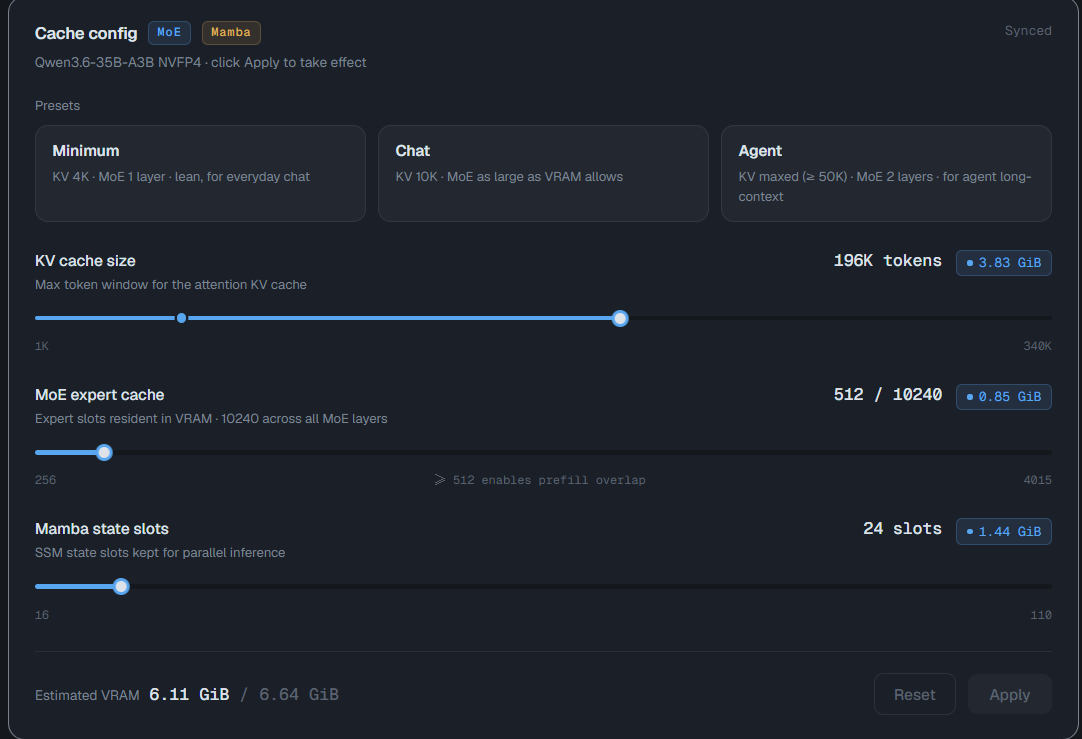
FreeToken から Claude Code 等のコンソールを開くことができるのでお気楽です。
メニューの Apps から、Working directory を設定して Launch するとそれ用のモデルで開いてくれます。
Zed editor で設定する場合は、ctrl + shift + p から agent: open setting を開いて、LLM Provider から + Add Provider -> OpenAI を選んで、API URL に http://localhost:1919/v1 を入力すればOK。
token は dymmy とかでいいです。
使い勝手はモデルによりますが、Qwen3.6 はかなり優秀のようで、ちょっとしたスクリプトやPythonのコード書いてもらうのなら特に問題ないみたいです。
Rustのコードは少し不安はありますが、動いてはいます。
感覚的には Claude Haiku くらいやってくれるといいんですが、もうちょい使ってみないと分かりません。
クラウドAIを使っていても、ドキュメントを書くためのサブエージェント用に使うとかでトークン消費を抑えられそう。
たまに簡体字が混ざるので、この辺りは強めにエージェント用ファイルに書いとかないと駄目かもしれませんが。
副業
2026/05/24(Sun) 11:05
最近の日記が自分で作ったソフトの紹介みたいになってるのでちゃんと日記書こうと思ったけど特にネタが無かったという話し。
ここ何年かの物価上昇に比べて、主業の給料が上がらないという憂き目にあっていまして、流石に腹立ったので副業を始めました。
結局Web制作/開発なんですけども、知り合いとかツテとかでまあそこそこに。
やってることの紹介はここではしませんが、1年半くらい前からこっそり始めた、という事だけメモしておきます。
そして税金周りがクソ面倒。
ちょっと前に国民民主の玉木が所得控除の徴収下限額の事を「103万の壁」とか言ってましたが、ぶっちゃけ所得税はどうでもよくてむしろ払うのよ所得税は。住民税もね、大した金額じゃないから。
問題は社会保障費(国保、国民年金)の徴収下限額なんですよ。
年収130万超えたら発生しますが、取られる額がでかいし(20万くらい)、事業主側も同じ額払わんといかんというので、マジでこれ以上働く意味がない。
バカみたいに増えてる社会保障費抑える政策やんないとマジで日本潰れるんちゃうかと。年寄りの医療費1割負担優遇措置止めて一律3割負担にするだけで相当浮く筈なんだが??
税金チューチュー構造が壊れるから政治家も手入れたくないんでしょうが、日本のこと考えた政治家が…いねえな我が国は。
主業の方ですが、別に利益出してないわけではないんですよ。ちゃんと利益出してるんですけどね、チームの人件費諸々の3倍近くは毎年コンスタントに入ってきてる筈なのだけど。
「数字見なきゃいけないと思ってるんだけど、見たくないんだよなあ」「プログラマだから」とかいう人が代表やってるので、推して知るべしか…。
何で辞めてないのか不思議ですが、さすがに今年がターニングポイントかな、とは考えています。
ローカルLLM用RAGサービス
2026/05/16(Sat) 14:05
ローカルLLM用RAGサービスを作りました。
何言ってんのか分かんないって?俺もわかんねーよ。
Ollamaをはじめとした、ローカルLLMにRAGを追加するアプリです。
RAG(Retrieval-Augmented Generation)とは、AIが回答を生成する際に、外部のデータベースや社内文書などから関連情報を検索し、その情報を基に文章を作成する技術です。
https://www.google.com/search?q=rag%E3%81%A8%E3%81%AF
要するに自分の事を知ってるAIをある程度簡単に作れるよ、という中間のアプリです。
ファイルを読み込んでインデックス化しないと使えないので、しっかり時間はかかります。
が、ストレージにためてる音楽ファイルを読ませて、LLM経由で自然言語で検索するとか、画像のEXIF情報で検索するとか、そういう使いかができるよ、というもの。
RAG自体は使わなくてもチャット用のUIからOpenAI APIに接続できるので、UIだけ使いたい場合でもまあ使えなくはないです。
大体公式に良いUIがあるのであんまり使わないでしょうけど。
日本語に対応しているRAGサービスはあまりない筈なので、もしよければどうぞ使ってください。
ちなみに私は一文字もコードを書いてない。設計とプロンプトだけであとは全部Claude。


